表格别硬扔大模型:先定清洗规则,再让 AI 补漏
廖宏 · 发布于 2026年10月29日 · 约 15 分钟
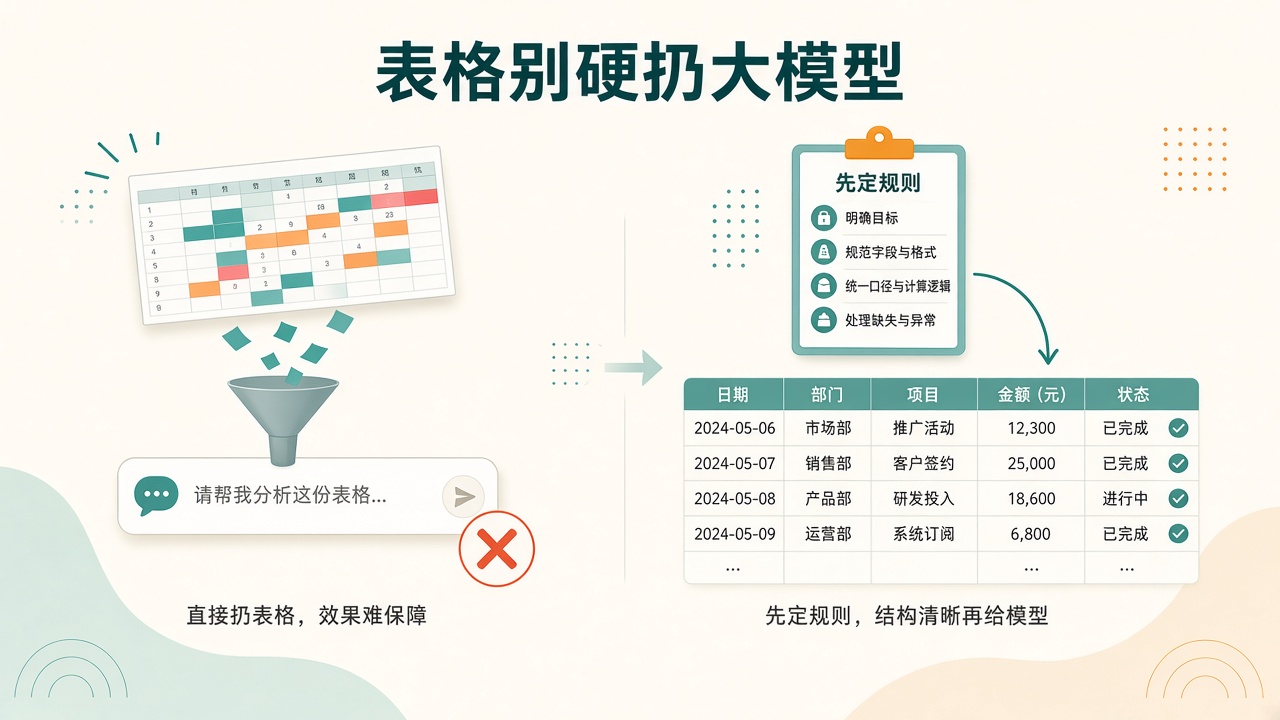
过去两年我做企业 AI 落地培训,最常见的翻车场景几乎都围绕着一张 Excel 表。
业务人员把几十列、几千行、排版杂乱的表格全选复制,或者直接拖进网页版对话框:“帮我清洗数据,提取有效信息并去重。”等十几秒,AI 吐出看似规整的表格,很多人不细查就贴回交差。结果月底对账财务金额对不上,运营发现核心客户凭空蒸发,订单日期也被改成了当天。
大模型真不是全自动碎纸还原机,而是用法一开始就错了。我是廖宏,今天拆解一套在内训中反复验证的打法:表格绝不能直接硬扔给大模型;必须由人先立规则,再让 AI 做局部填补、校验和脚本生成。规则在人,模型在后。
一、为什么整表硬扔,十有八九会翻车?
很多人把大模型当成了底层的 SQL 数据库引擎,以为它能精准寻址、按行列运算。事实并非如此。
在大模型眼里,表格只是一串很长的文字符号(Token)。它不靠行列坐标或内存指针计算,而是基于概率预测下一个字符。面对整张复杂表格,它天生存在三大软肋:
1. 结构上下文漂移与“偷懒吞行”
表格超过两三百行转为纯文本后,Token 消耗极高。大模型在长文本中容易发生“中间迷失”。为契合输出长度限制,它常会自作主张加上“(中间省略 200 行)”,或在角落悄悄漏掉十几行。业务数据一旦遗漏,后果极难挽回。
2. 合并单元格与视觉排版的“理解黑洞”
很多表格带有层层合并的表头、状态高亮色块、单元格内换行塞入的多段地址。人眼或许能勉强识别,但转为线性文本后,合并单元格的空间拓扑关系完全丢失。错位一旦发生,模型就会张冠李戴,把 A 的信息填到 B 头上。
3. 概率性幻觉与数值、日期的悄悄篡改
大模型擅长根据语境推断,面对缺失值时它往往不会留空,而是编造看似合理的区号或编号。遇到混杂的日期格式(如 2024/03/05、05-04-2024 与 2024.3.5),稍微推断偏差就会导致全表时序混乱。
不要指望大模型一键把垃圾变成金子。垃圾进,出来的只会是包装精致的垃圾。
二、动键盘之前:先把清洗规则定在纸上
在让 AI 介入之前,必须先将表格视为规范的结构化数据。
早在电子表格应用初期,规范化原则就已被确立。例如 Microsoft 支持:在工作表上组织和设置数据格式的指南 指出:每列必须包含同质数据项、首行必须是唯一简明的表头、避免随意插入空行空列、严禁混淆文本与数值。
而在科研领域,PLOS Computational Biology:表格数据管理实践 也强调:保证单元格原子化(一格一事实)、原始数据只读保留、清洗过程必须留存追溯记录。
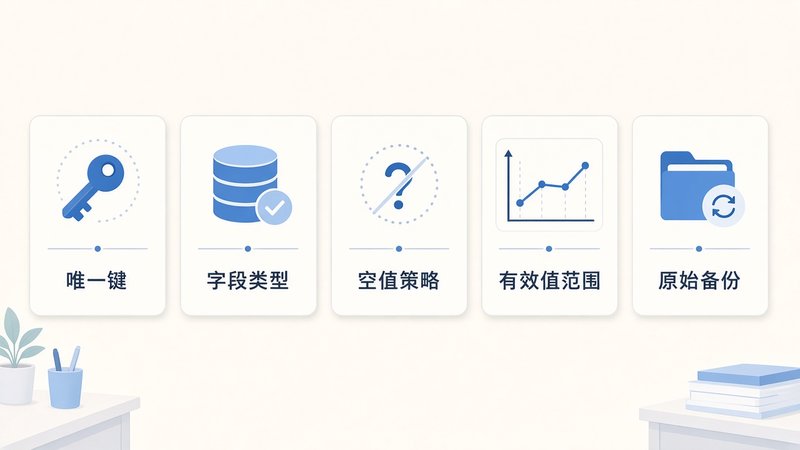
结合日常业务,在找 AI 前先在草稿纸上定死以下五条规则:
规则 1:确定唯一键(Unique Identifier)
每行数据靠什么唯一标识?是工号、手机号、流水号,还是“姓名+身份证后四位”?没有唯一键,去重无从谈起。泛泛要求 AI 去重,它很可能把同名员工或不同日期的同一客户复购记录直接删掉。
规则 2:定义字段类型与原子化边界
检查每列属性。日期统一采用单一格式(如 YYYY-MM-DD);金额必须为纯数字,剥离货币符号与千分位逗号。切忌在一个单元格内混存两个维度,如“张三(已离职)”必须拆为“姓名”与“在职状态”两列。
规则 3:明确空值与异常值处理策略
空白单元格代表未填报填 NA、代表数值为 0,还是沿用上行?必须设定明确规则,不可让大模型自由发挥。
规则 4:圈定有效值范围(枚举与边界)
限定枚举值。如“性别”仅限“男/女/未知”;“省份”必须统一为标准名称,不能“广东”、“广东省”、“粤”混用。
规则 5:确立原始数据的冷冻机制
先复制一份备份命名为 raw_data_backup.xlsx 并设为只读。永远不在原始表上直接修改。
梳理完这些规则,你对数据就有了绝对把控,AI 才会从搅局者转变为顺从的执行工具。
三、让 AI 补漏的正确姿势:把模型当打工人而不是主理人
定好规则后,重点是让 AI 针对具体规则提供工具、执行局部任务、核验特例。
1. 让 AI 充当函数与正则表达式的编译器
无需手写复杂的嵌套函数或正则,只需向 AI 描述规则,让它输出可直接在本地运行的公式。
- 差的提问: “帮我整理这一列手机号。”
- 好的提问: “Excel A 列有混杂
+86、空格、横杠的联系方式。请写公式去除所有非数字字符;若以 86 开头且为 13 位,截取后 11 位;若最终不是以 1 开头的 11 位数字,显示[格式异常]。”
在本地软件中跑公式,几万行毫秒级完成,确定性 100%,不会吞行且过程清晰可控。
2. 让 AI 编写确定性的 Python 或 VBA 脚本
当数据量上万或跨文件合并时,公式往往吃力,此时让模型按规则生成一段 Python(pandas)脚本最佳。
将前 3 行脱敏样本和规则喂给它:
“表头结构为:
['order_id', 'user_info', 'pay_time', 'amount']。
请用 Python pandas 编写脚本:
order_id为唯一键,重复时保留pay_time最新记录;user_info(格式为姓名-电话)拆分为name与phone,无法解析的记录写入cleaning_errors.csv;pay_time统一转为YYYY-MM-DD hh:mm:ss,异常值置空;amount剔除货币符号与逗号,转为 float 保留两位小数。
输出完整脚本并包含异常捕获。”
本地运行脚本既无数据泄露风险,报错时还能根据行号精准排查。
3. 小切片抽取与模糊实体归一化
面对规则难以穷尽的非结构化脏数据(如自由填写的冗长地址),正是大语言模型发挥长处的环节,但切忌全量上传。
正确方式:先在本地过滤出无法匹配的几十条疑难行;构建少样本(Few-Shot)提示词,让 AI 仅输出键值对或标准 JSON;最后将结果粘回主表并标色,人工快速抽检验收。
4. 做规则与逻辑的对撞检查器(Prompt Audit)
把既定规则与小批量样本发给 AI 提问:“这是我的清洗规则与 10 行样本。请从严谨性角度指出:哪些边界情况(如跨年、负数退款、同名同姓)可能导致规则误伤有效数据?”让 AI 寻找特例往往比直接洗数据更稳妥。
四、在企业内训现场,我是怎么给业务部门演示的?
在内训中,我常拿学员的真实脏表做现场对比演示。
一次,某制造企业销售运营拿来一张几千行的线索表,学员习惯性把前 500 行贴进大模型去重筛选。
我做了两组演示:
第一组:直接硬扔法
模型很快输出 38 行规整表格。但随后通过 Python 统计核对:原表里高意向线索其实不少,模型返回的结果却漏掉了大半有效线索,甚至还擅自改动了个别客户的跟进人姓名。
第二组:规则定死加 AI 辅助的标准四步法
- 结构透视(人来做): 梳理表头发现核心字段仅有【录入时间】、【线索详情】、【销售阶段】、【跟进人】。在 Excel 中取消所有合并单元格,批量删除杂乱的小计与空白行。
- 生成提取公式(AI 做翻译): 【线索详情】中混杂着“李总-138xxxxxxxx-想看样品”等不同句式。让 AI 生成正则或文本拆分公式,填入后双击填充,4000 多行瞬间分拆完毕。
- 隔离异常行(机器做筛选): 通过条件格式筛选出返回
#VALUE!或空的单元格,只筛出几十行特殊记录(如座机带分机、微信号)。 - 切片投喂补漏(局部精细活): 把这几十行文本单独发给 AI:“从下列文本提取姓名、电话或微信号,缺失填
NULL,制表符分隔输出。”数据量小,模型零幻觉完成。粘回主表,全流程耗时不到 10 分钟。
AI 擅长在给定边界内执行脏活,而不是替业务做判断。
五、建立属于你自己的表格处理工作流
把表格与 AI 结合的高效模式可以归纳为以下漏斗:
原始数据(备份留存)
    ↓
【人】定义规则:唯一键、字段属性、空值策略
    ↓
【AI】生成工具:Excel函数、VBA宏、Pandas脚本
    ↓
【本地执行】大批量确定性清洗,快速过筛
    ↓
【筛选隔离】剥离出 5% 难以用规则覆盖的长尾异常
    ↓
【AI】局部补漏:利用自然语言理解能力做切片清洗
    ↓
【人】快速抽检,合并交付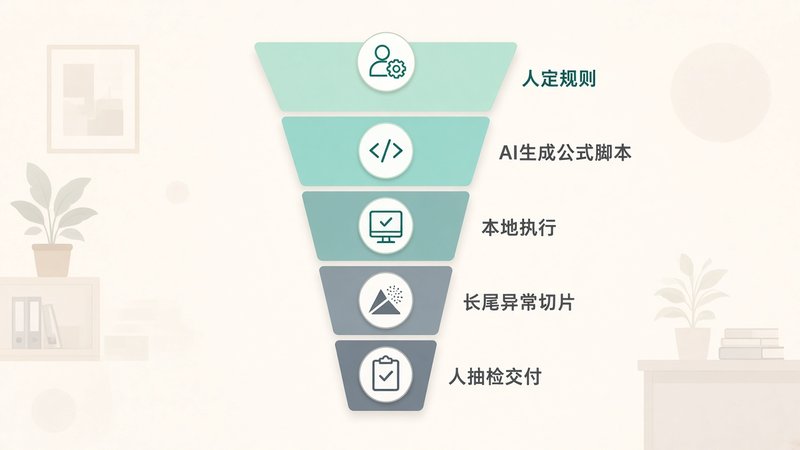
面对杂乱表格时,先克制整表粘贴的冲动,在纸上明确表头与规则。确定性永远高于概率,让规则掌舵,让模型摇桨。
常见问题
Q1:几十万行的超大 Excel 表格,大模型连文件上传都会报错,这种该怎么处理?
答: 切勿直接上传几十万行的原始文件。正确做法是截取 5 到 10 行脱敏样例发给 AI,说明业务逻辑,让它编写使用 pandas(配合 chunksize 分块读取)的 Python 脚本。脚本在本地秒级运行,既规避了上下文超限与数据安全风险,又能稳定支撑百万级数据。
Q2:让 AI 写的 Excel 函数或 Python 脚本,如果我自己看不懂代码,怎么保证它没写错?
答: 核心在于“小样本沙盒验证”。先抽取 20 到 30 行包含空值、特殊符号、边界值的测试小表,在测试表上跑模型生成的公式或代码,人工核验结果。也可将代码贴回另一个模型窗口,让其逐行解释逻辑并提示潜在边界漏洞,确认无误再全量执行。
Q3:有些文本字段非常口语化,规则写不出来,必须全靠大模型理解,难道真的不能批量扔吗?
答: 依赖语义理解的非结构化字段,也不可在聊天窗口整表大段粘贴。建议使用支持 API 的脚本或表格插件,以 10 到 20 行为一组分批发送,要求返回带原行号的结构化 JSON。某批报错只需重试局部批次,避免整表错位或吞行。